从显存到分布式缓存:LMCache、Mooncake 与推理框架如何管理 KV Cache
在单机推理中,KV Cache 通常只是引擎内部的一块显存。上下文和并发规模上升后,它会跨出 GPU,进入 CPU、NVMe 和远端节点。随之而来的索引、放置、传输、逐出、持久化与监控问题,已经超出 Attention 内核本身的职责,也会影响推理框架怎样调度请求。
LMCache 和 Mooncake 处理的是这套系统的不同部分。LMCache 偏向 KV Cache 管理层,负责索引、分层、逐出和预取;Mooncake 偏向 分布式存储与传输数据面,负责跨节点保存和搬运大块 KV。它们既能单独接入推理框架,也能组合部署。
全文围绕五个问题展开:
- LMCache 管什么?它通过 Connector 接入 vLLM 等运行时,把 KV Cache 从 GPU 扩展到 CPU、本地盘和远端后端,并提供索引、逐出、预取、共享和观测能力。
- Mooncake 管什么?Transfer Engine、Mooncake Store 以及 Prefill/Decode 分离连接器,解决高速 KV 传输和分布式存储问题。
- 两者怎样配合?在 LMCache 多进程架构中,Mooncake Store 可以作为 L2 适配器;PD 分离场景也可以直接采用 Mooncake Connector 做点到点 KV 传输。
- 缓存复用不等于活跃 KV 超卖。把已完成或暂时不活跃的 KV 保存到 CPU/SSD,与“正在 Decode 的请求被抢占后,将其 KV 原样保全并恢复”,是两个不同问题。
- 显存只容纳 5 份满上下文时,8 个请求怎么运行?请求级时间片和抢占保全可以让它们轮转推进,但不会增加 GPU 的瞬时驻留容量。让 Attention 直接读取 CPU 或远端 KV,需要另外改造内核和内存管理。
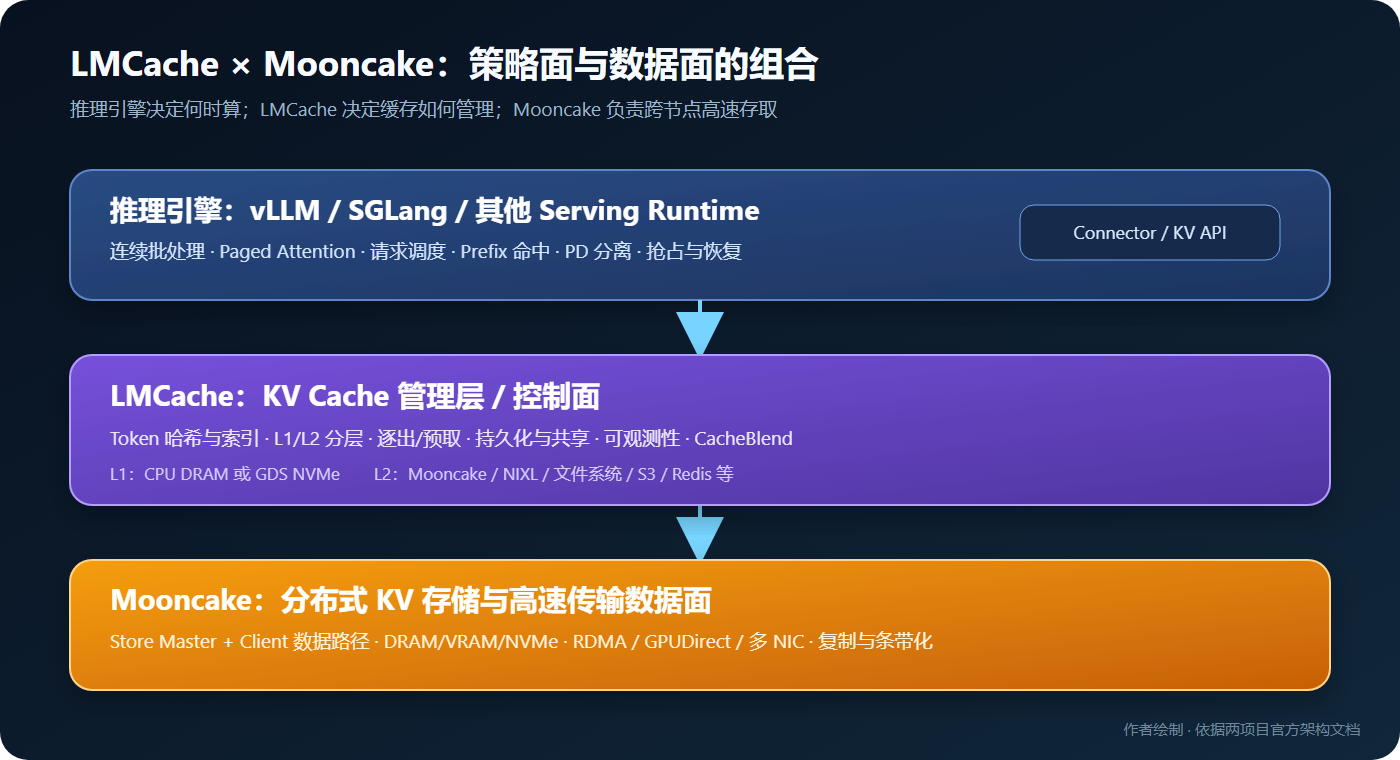
图 1:LMCache × Mooncake 的推荐分层。作者依据两项目官方架构文档绘制。
1. 先把几种“KV 卸载”分开
KV Cache 保存了自回归生成过程中每层 Attention 的 Key/Value。没有它,生成每个新 token 时都要重新计算整个历史前缀。它的空间消耗近似随层数、KV head 数、head dimension、数据精度、上下文长度和并发数线性增长:
$$\text{KV bytes} \approx 2 \times L \times H_{kv} \times D \times B \times T \times C$$
其中 2 对应 K 与 V,L 是层数,Hkv 是 KV head 数,D 是 head dimension,B 是每元素字节数,T 是上下文 token 数,C 是并发序列数。对 GQA、MLA、滑动窗口和混合注意力模型,实际布局会更复杂,但“上下文和并发越高,KV 越快吃满显存”这一趋势不变。
讨论 LMCache、Mooncake 或 llama.cpp 前,至少要区分四种常被混为一谈的语义:
| 语义 | 典型动作 | 主要目的 | 是否直接帮助活跃请求继续 Decode |
|---|---|---|---|
| 静态放置 | 初始化时让 KV 固定驻留 CPU 或 GPU | 显存不足时保证能运行 | 可以,但 CPU/设备访问可能显著变慢 |
| Prefix/历史缓存卸载 | 将已生成且可复用的块保存到 CPU、盘或远端 | 避免未来请求重复 Prefill | 通常不直接改变当前请求的驻留上限 |
| 抢占保全 | 请求被挂起前 D2H 保存,恢复前 H2D 载入 | 避免被抢占请求从头重算 | 可以让更多请求轮转推进,但不是同时驻留 |
| 每步远端流式读取 | Attention 计算时按页/层拉取非 GPU KV | KV 超额并行 | 理论可行,但需要内核共设计,带宽压力最大 |
还有第五个经常被误用的词:权重卸载。例如 vLLM 的 --cpu-offload-gb 针对模型权重,不是 KV Cache。权重与 KV 的生命周期、访问模式和调度粒度不同,不能用同一个参数推导出相同能力。
2. LMCache 是什么:推理引擎之外的 KV Cache 管理层
LMCache 官方把自己定义为“面向 LLM 推理的 KV Cache 管理层”。它将 KV 从一次推理调用的临时状态,变成可持久化、可跨请求/会话/引擎实例复用、可观测并可变换的数据对象。官方重点场景包括长上下文 Agent、多轮对话和 RAG。LMCache 首页
2.1 它补的是推理框架的哪块能力
vLLM 或 SGLang 擅长在 GPU 内部安排批次、管理页式 KV、执行 Attention;但一旦 KV 离开本地 GPU,就会出现一组不适合塞进模型执行循环的问题:
- 如何把 token 序列稳定映射到缓存块;
- 如何管理 CPU、NVMe、远端存储之间的层级;
- 哪些块该逐出、固定、预取或删除;
- 如何让多个引擎实例共享缓存;
- 如何衡量 token 级命中、传输时延和缓存生命周期;
- 如何避免存储 I/O、Python GIL 或故障拖垮推理主进程。
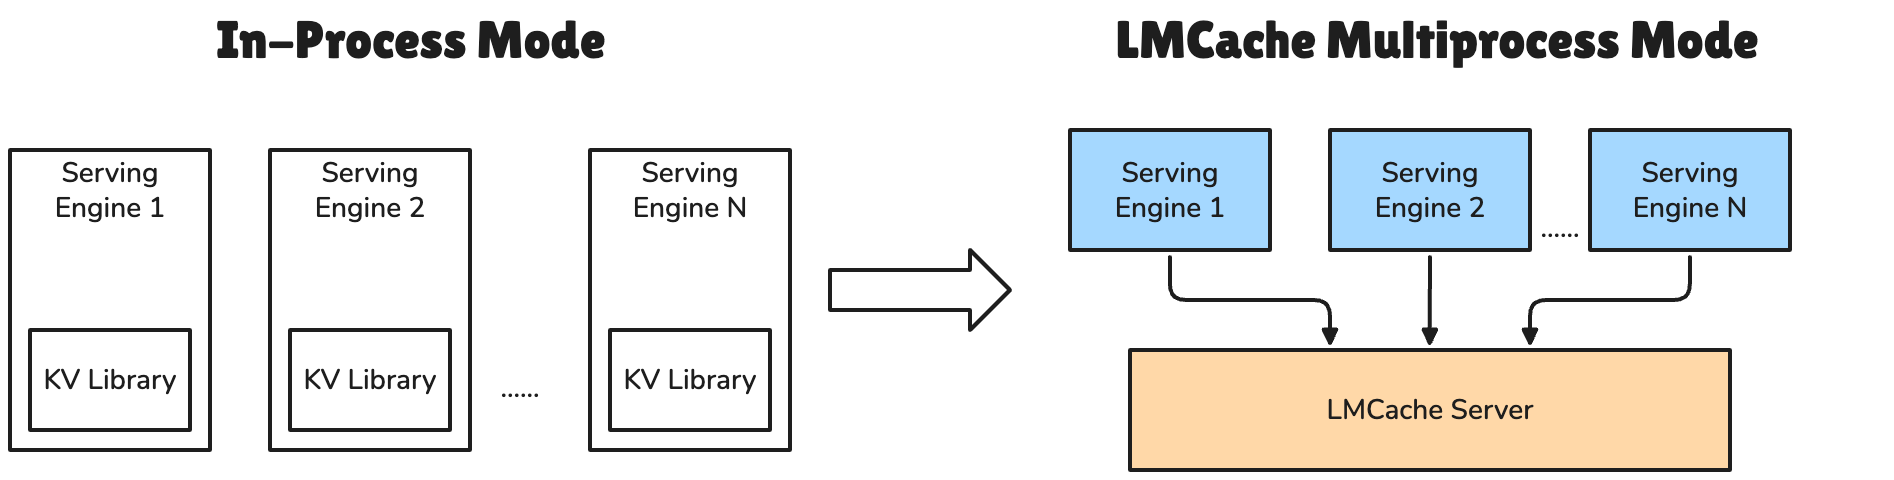
LMCache 的多进程(MP)模式因此把缓存服务从推理引擎进程中拆出。一个节点上的多个 vLLM 实例可以通过 ZMQ 或 gRPC 访问同一个 LMCache 服务,获得进程隔离、共享 L1 和独立资源扩展。LMCache MP 架构
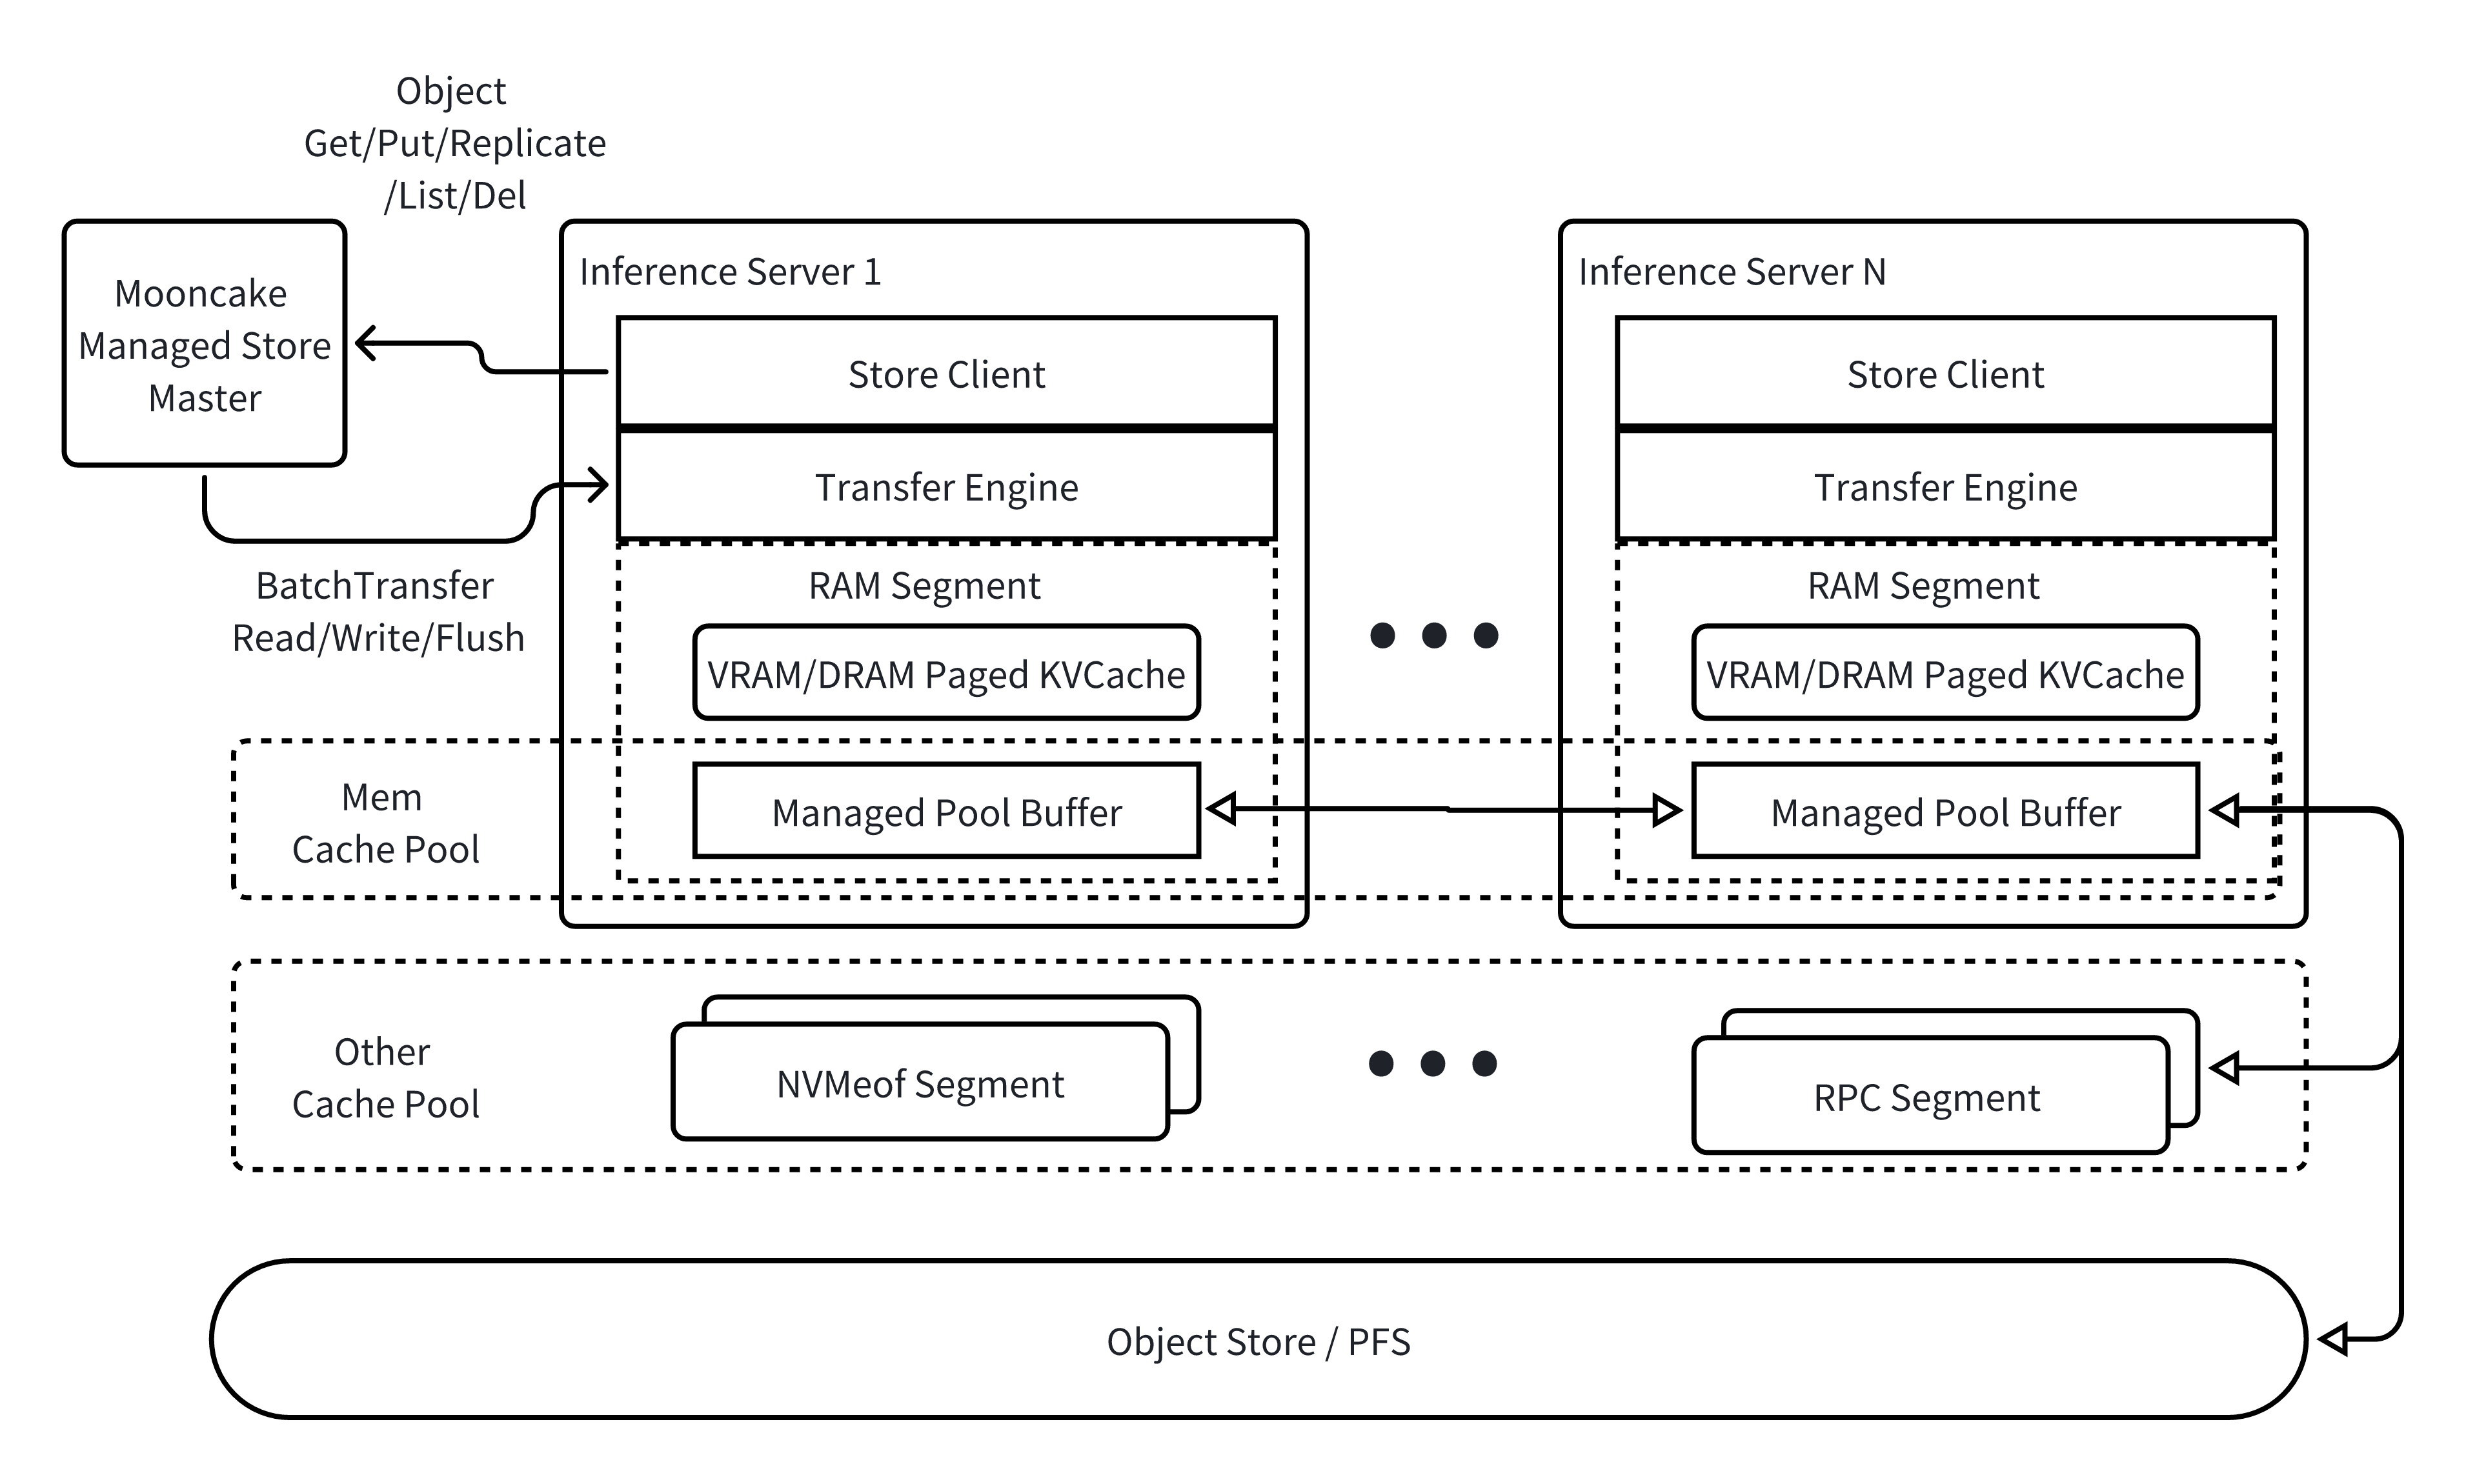
图 2:LMCache 的进程内与多进程部署模式。图片来自 LMCache 官方文档。
2.2 LMCache 的分层模型
从逻辑上看,LMCache 把缓存路径拆成:
- GPU 活动工作集:参与当前推理的 KV 页;
- L1 快速层:默认是固定 CPU DRAM,也可以是由 GDS/hipFile 驱动的 NVMe slab;
- L2 持久层:文件系统、原始块、NIXL、S3、Redis/Valkey、Mooncake Store 等后端;
- 索引与控制面:TokenHasher、SessionManager、StorageManager、Store/Prefetch/Eviction Controller,以及指标和管理 API。
在 MP 模式中,vLLM 通过 STORE 把 KV 写入 L1;StoreController 再异步推送到 L2。读取时先 LOOKUP L1,未命中则由 PrefetchController 查询 L2,命中后拉回 L1,再通过 RETRIEVE 返回给引擎。LMCache 二级存储数据流
除了执行显存到内存的复制,LMCache 还管理 KV 对象从写入、查询、预取到逐出的整个生命周期。
2.3 LMCache 擅长什么
- 跨请求、跨会话、跨实例的 Prefix KV 复用;
- CPU、NVMe、远端后端之间的多级缓存;
- 异步 Store、Prefetch 和逐出;
- 独立服务化、共享缓存、配额和可观测性;
- 通过 CacheBlend 做非纯前缀的选择性复用;
- 支持 PD 分离中的 KV 传输,以及与不同存储/传输后端解耦。
LMCache 本身不负责模型执行,也不会自动改变 vLLM 调度器的抢占语义。如果推理框架只把已经完成、可作为 Prefix 的块交给它,它优化的就是后续复用;要保全因显存不足而被抢占的运行中请求,调度器和 Connector 还要增加相应流程。
3. Mooncake 是什么:KV 中心的分离式推理与高性能数据面
Mooncake 起源于 Moonshot AI 的 Kimi 推理平台,采用以 KV Cache 为中心、存算分离的架构。当前开源版本主要包含两部分:
- Transfer Engine:面向 DRAM、VRAM 和 NVMe-oF Segment 的零拷贝、高带宽传输库;
- Mooncake Store:专为大模型推理设计的分布式 KV 存储引擎。
Mooncake 既可以作为 LMCache 的远端后端,也可以通过 Mooncake Connector 直接承担 Prefill 与 Decode 节点之间的 KV 传输。Store 和 Transfer Engine 在这两种部署中承担不同角色。
3.1 Mooncake Store:元数据集中,数据路径点到点
Mooncake Store 包含 Master Service 与 Client:
- Master 管理逻辑存储池、节点成员、对象空间分配和元数据;
- Client 一方面向上提供
Put/Get/Remove等对象接口,另一方面可以贡献本机连续 DRAM/VRAM/NVMe 资源; - 数据传输发生在 Client 之间,不经过 Master 的数据面,因此 Master 不成为大对象搬运瓶颈。
Store 面向 KV 大对象提供条带化、多副本、动态资源扩缩容、RAM 到 SSD 的下沉,以及基于 Transfer Engine 的零拷贝/多 NIC 传输。Mooncake Store 设计
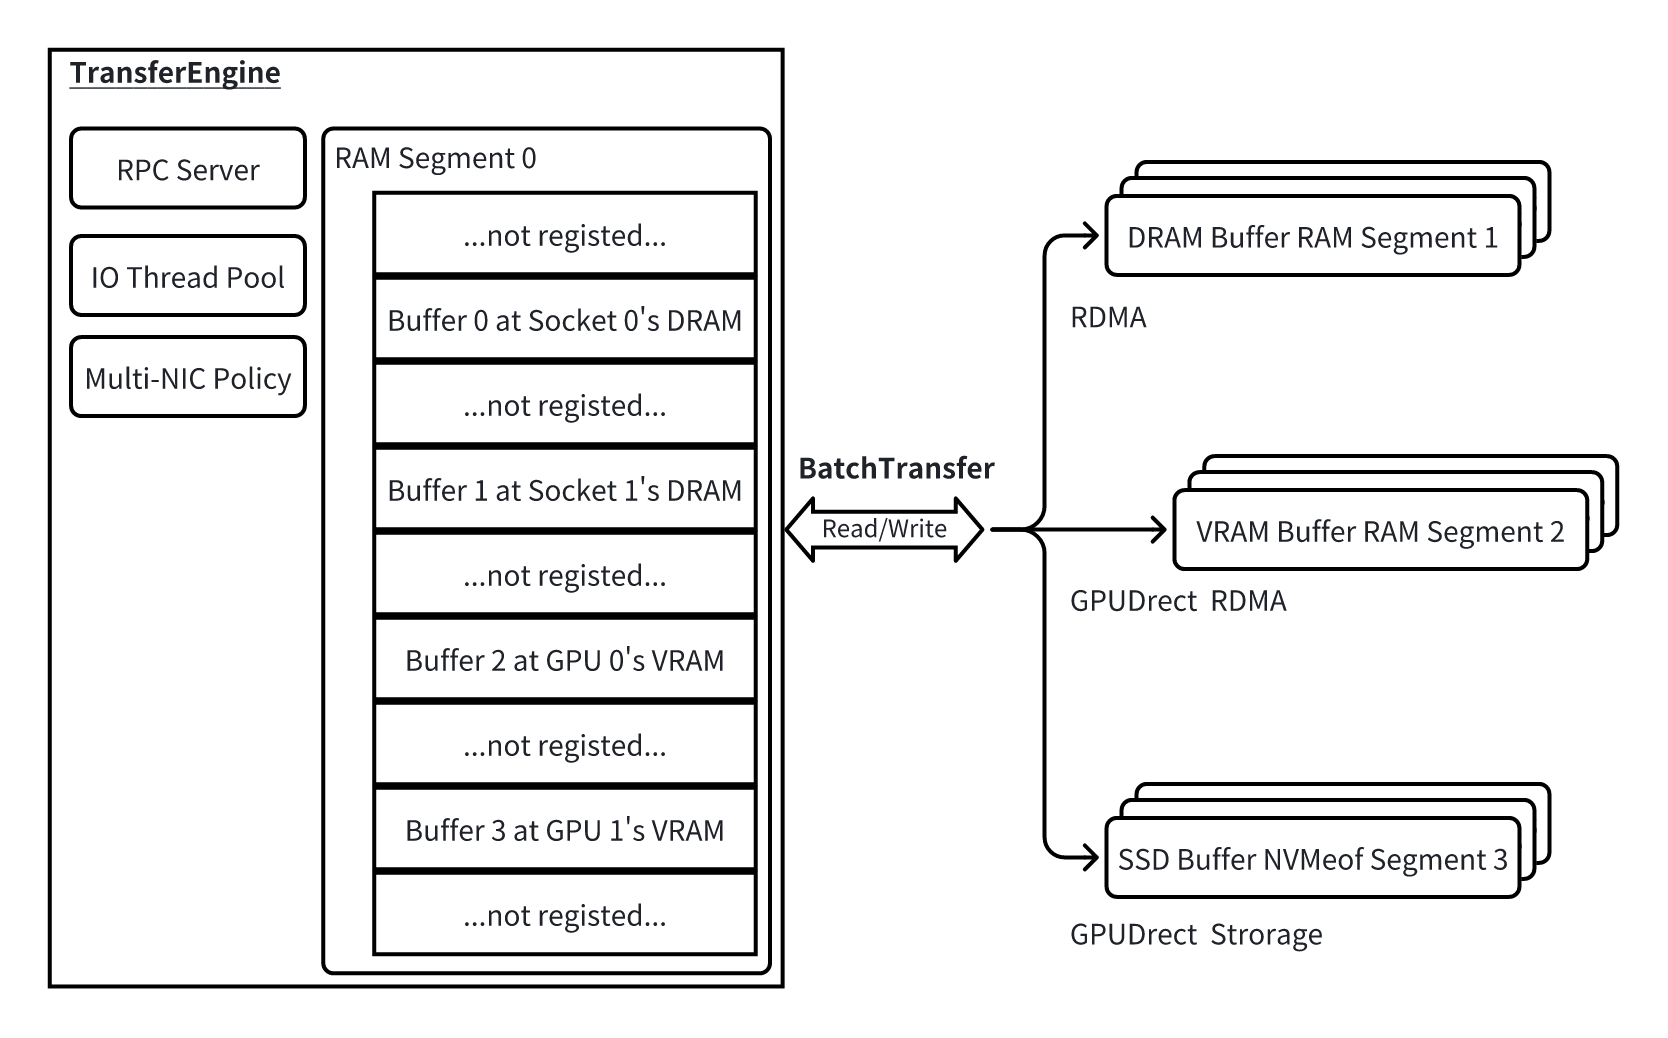
图 3:Mooncake Store 的 Master、Client、Transfer Engine 与多级缓存池。图片来自 Mooncake 官方文档。
3.2 Transfer Engine 如何搬运数据
Transfer Engine 以 Segment 和 BatchTransfer 为核心抽象。Segment 可以来自 DRAM、VRAM 或 NVMe-oF;BatchTransfer 描述一批非连续地址之间的异步双向传输。官方文档列出的传输后端包括 TCP、RDMA、EFA、NVMe-oF、NVLink、HIP 等,并支持 GPUDirect RDMA、多网卡池化和拓扑选择。Transfer Engine 设计
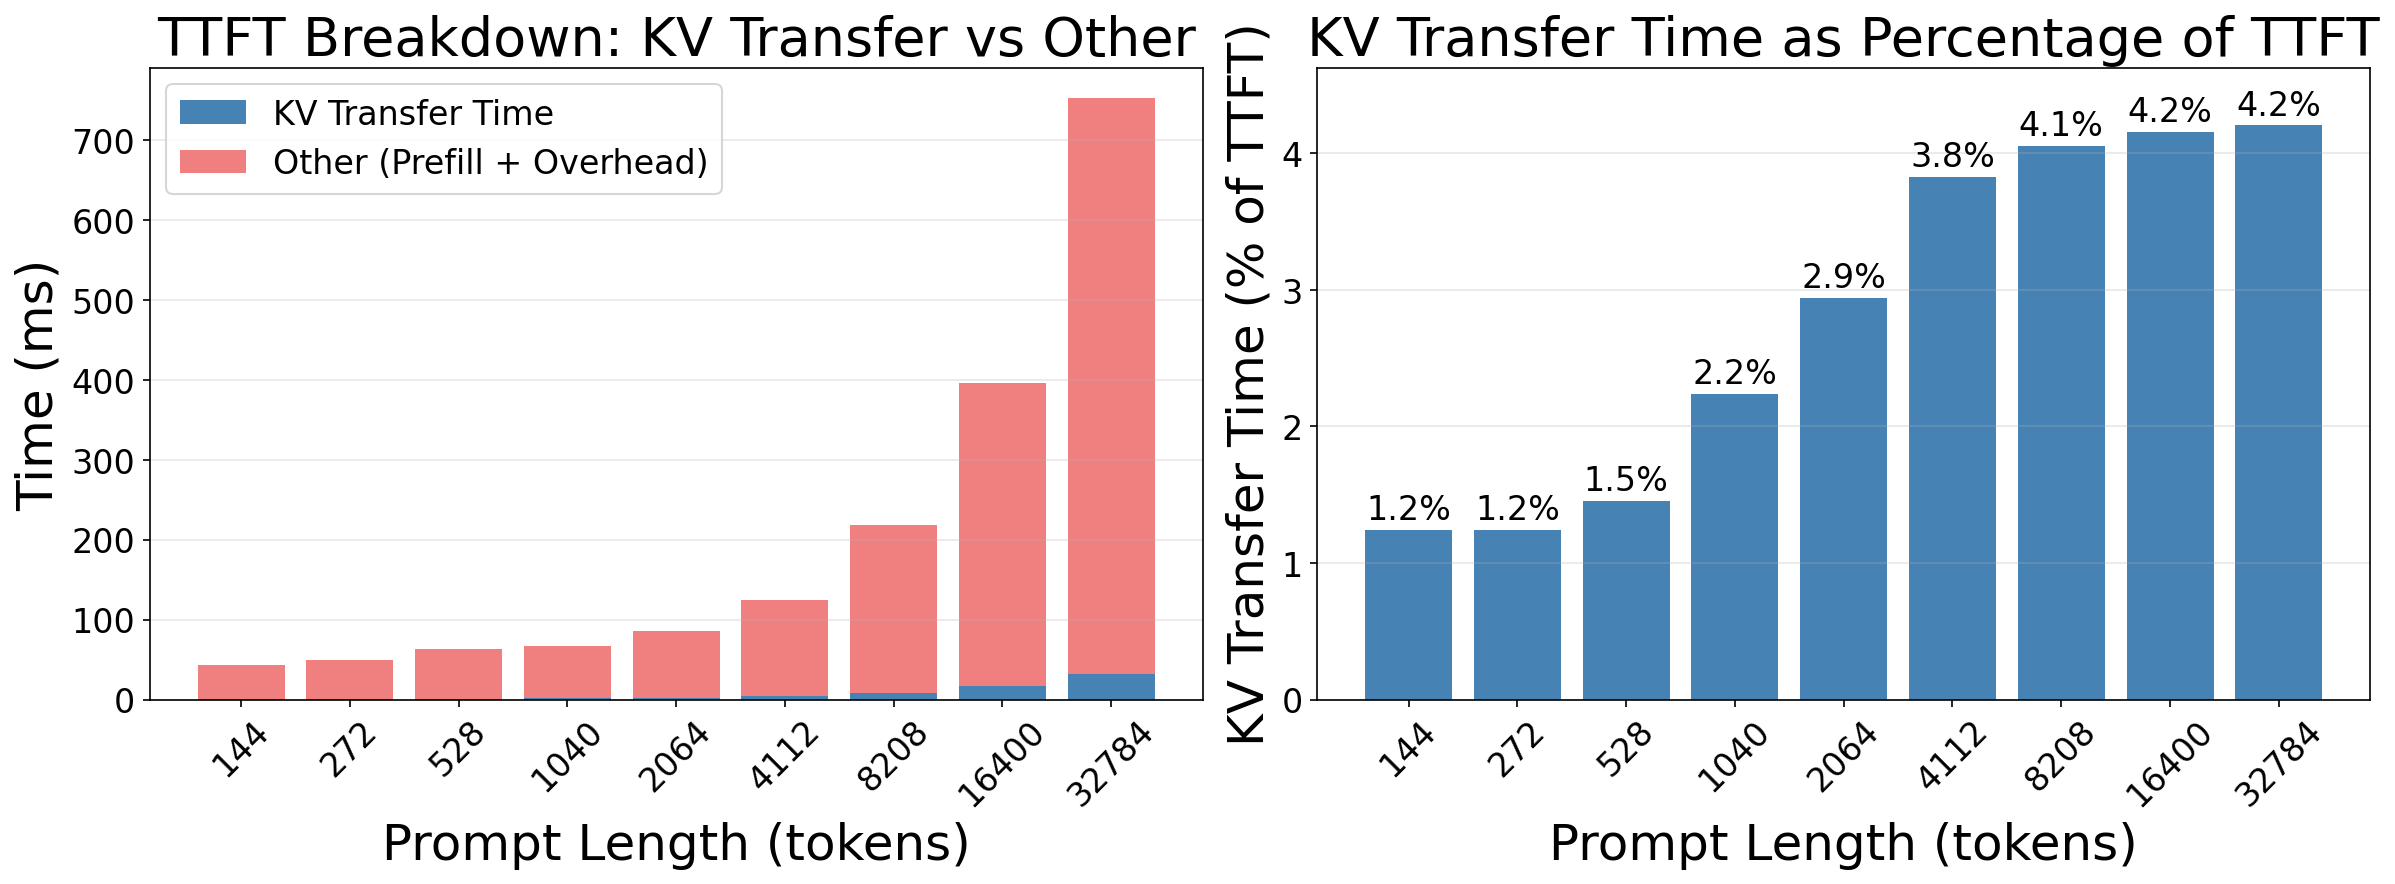
图 4:Mooncake Transfer Engine 的 Segment、Buffer 与批量传输抽象。图片来自 Mooncake 官方文档。
3.3 Mooncake 擅长什么
- Prefill/Decode 分离后的跨节点 KV 数据传输;
- 基于 RDMA/GPUDirect 的低 CPU 开销、高带宽路径;
- 分布式 DRAM/VRAM/NVMe 资源池;
- 大对象条带化、复制、热点缓解和拓扑感知;
- 作为 vLLM、SGLang HiCache、LMCache 等系统的数据面或后端。
Mooncake Store 关注 KV 的存取和传输。至于哪些 KV 值得保存、怎样按会话价值逐出、如何统一多个后端以及怎样提供命中率和配额,这些更接近 LMCache 的职责。
4. LMCache 与 Mooncake:相同点、不同点和容易混淆的地方
4.1 相同点
两者都把 KV Cache 从引擎内部的临时 buffer 提升为可管理对象,并共享一些系统观念:
- KV 应该能够离开 GPU,进入 CPU、SSD 或远端层;
- Store/Load 应尽量异步,减少对模型执行关键路径的阻塞;
- Prefix 与跨实例复用可以用存储/带宽换取 GPU 计算;
- PD 分离要求框架、连接器和传输层共同协作;
- 规模化部署需要可观测性、错误隔离和明确的一致性边界。
4.2 主要差别
| 维度 | LMCache | Mooncake |
|---|---|---|
| 项目定位 | KV Cache 管理层、策略与控制面 | KV 中心的分离式推理基础设施;Store 与 Transfer Engine 构成数据面 |
| 主要问题 | 缓存什么、放哪层、何时逐出/预取、如何跨实例复用 | KV 如何跨节点/介质高速传输、如何形成分布式资源池 |
| 上层接口 | vLLM/SGLang Connector、RPC、控制器、索引 | Store 对象 API、Transfer Engine、vLLM/SGLang/Mooncake Connector |
| 存储层级 | GPU 活动集 + L1 + 一个或多个 L2 适配器 | DRAM/VRAM/NVMe-oF/SSD/外部对象存储组成的分布式池 |
| 策略能力 | Token 哈希、会话、逐出、预取、固定、配额、观测、CacheBlend | 空间分配、条带化、复制、传输路由、拓扑与资源管理 |
| 后端选择 | 把 Mooncake、NIXL、文件、S3、Redis 等统一在管理层之后 | 本身就是一个高性能后端,也可直接作为 PD 传输层 |
| 最适合的独立用法 | 单机/集群的 Prefix 复用与多层 KV 管理 | 高带宽 PD 分离、跨节点共享池、远端大对象传输 |
| 是否等价于活跃 KV 抢占保全 | 否;需要引擎调度器/Connector 显式配合 | 否;它提供传输/存储能力,但抢占时机仍由推理框架决定 |
按系统分工来理解,LMCache 接近缓存管理器,Mooncake 接近为 KV 优化的分布式内存与高速 I/O 子系统。两者有重叠,但不在同一抽象层。
5. 两者如何组合:LMCache 管策略,Mooncake 跑数据
LMCache 与 Mooncake 已有官方集成。LMCache MP 模式提供原生 Mooncake Store L2 适配器;在 RDMA 模式下,LMCache 必须提供有效且连续的 L1 内存区域,适配器再把 Mooncake 的元数据、Master 地址、协议和 Segment 配置接入后台工作线程。LMCache 的 Mooncake Store L2 文档
典型写入路径是:
- 推理引擎生成 KV 页;
- Connector 将需要保存的 KV 提交给 LMCache L1;
- StoreController 根据策略异步把 L1 对象推送到 Mooncake L2;
- Mooncake Master 决定对象放置,Client 通过 Transfer Engine 把数据写入目标 DRAM/VRAM/SSD Segment;
- 只有在复制完成并满足一致性条件后,源 GPU 页才可以安全复用。
读取路径则反过来:
- 新请求先由引擎/LMCache 查找可复用前缀;
- L1 未命中时,PrefetchController 查询 Mooncake L2;
- Mooncake 定位对象并通过合适的数据路径拉回 L1;
- Connector 将 KV 送回 GPU 页;
- 引擎跳过已命中的 Prefix,仅计算未命中后缀。
5.1 不要把所有路径都叠在一起
生产部署至少有三种模式,应按目标选择:
- vLLM + LMCache(CPU L1):适合单机长文档、多轮对话和重复 Prefix;简单,先验证复用收益。
- vLLM/SGLang + Mooncake Connector:适合 PD 分离,重点是 Prefill 节点到 Decode 节点的低延迟 KV 传输。
- vLLM + LMCache + Mooncake Store:适合集群级持久复用;LMCache 提供管理、索引和策略,Mooncake 提供远端容量与高带宽数据面。
这三者不是“组件越多越快”。一次远端命中只有在“传输耗时 + 排队耗时”小于“重新 Prefill 的耗时”时才有价值。短 Prefix、低命中率或拥塞网络下,远端缓存可能是负优化。
5.2 如何理解官方性能数字
官方联合测试在 8×H800、Qwen2.5-72B、50 个并发请求、每个输入 9,728 token 的环境里,对比冷启动与缓存命中,报告平均 TTFT 从 21.7 秒降至 6.7 秒,请求吞吐量从 1.11 req/s 增至 3.23 req/s。Mooncake × LMCache 联合测试
另一组 Mooncake vLLM PD 分离测试在特定 H800/RoCE 环境中达到 142.25 GB/s 峰值实际传输带宽;32,768-token Prompt 对应 4.50 GB KV,传输耗时 31.65 ms。它证明高端互联下数据移动可以很快,但不应外推到普通 PCIe、TCP 或公有云网络。Mooncake vLLM 基准
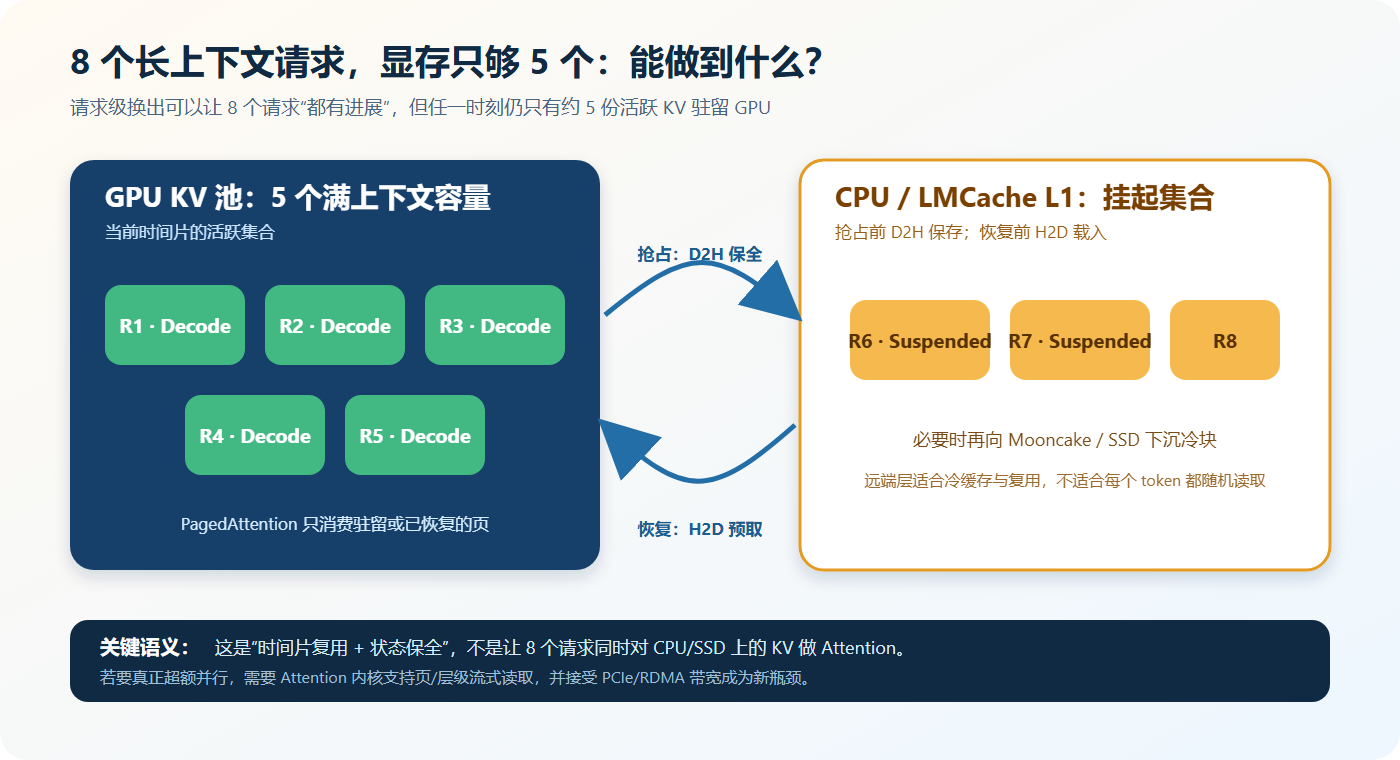
图 5:Mooncake 官方 vLLM PD 分离基准中的 TTFT 分解。该数字只适用于文档所列硬件、模型、软件版本与网络拓扑。
LMCache 自身的 CPU 卸载教程则在重复长文档问答工作负载中报告平均 TTFT 从 757 ms 降至 185 ms,核心原因是被 GPU 逐出的 Prefix 块仍能从 CPU 恢复,而不必重新 Prefill。LMCache 基准教程
这些测试能支持的结论很有限:在高复用工作负载中,保存和加载 KV 可能比重算划算。换一种流量或网络环境,收益需要重新测量。
6. 接入推理框架后,难点落在调度器
推理框架接入分层 KV Cache,至少要完成三层协同。
6.1 数据层:块格式必须可互认
缓存键至少应包含:模型 ID 与精确 revision、tokenizer 与模板版本、RoPE/位置编码参数、KV dtype、block size、Attention 布局、TP/PP/DP 拓扑、LoRA/Adapter、量化配置,以及可能影响状态的 speculative decoding 参数。
如果只对 token 序列做哈希,而忽略这些上下文,同一个键可能对应不同张量布局或不同语义,缓存命中会变成静默的数据污染。
6.2 调度层:把缓存位置和恢复代价变成一等输入
传统调度器只看请求队列、可用 GPU block 和 token budget。接入 LMCache/Mooncake 后,还应该知道:
- 请求的多少 KV 已在 GPU、CPU、SSD 或远端;
- D2H/H2D 的预测耗时和当前链路拥塞;
- 该 Prefix 的未来复用概率;
- 被抢占后是“可快速恢复”还是“只能重算”;
- 请求的 SLO、等待年龄、租户配额和公平性权重。
一个更合理的抢占受害者评分可以写成:
$$\text{victim score} = \frac{\text{freed GPU bytes}}{\text{D2H cost} + P_{resume}\cdot\text{H2D cost} + \text{fairness penalty} + \text{reuse loss}}$$
它比简单 LRU 或“已计算 token 最少者优先”更贴近真实系统成本。Mooncake 提供的拓扑/带宽信息、LMCache 提供的层级与命中信息,都可以成为这个模型的输入。
6.3 执行层:必须有一致性栅栏
抢占时最大的正确性风险是:异步 D2H 尚未完成,vLLM 已把同一物理 GPU block 分配给另一个请求。此时后台任务可能把新请求的数据写入旧请求的缓存键。
因此需要显式状态机:
GPU_RESIDENT → OFFLOADING → OFFLOADED → PREFETCHING → GPU_READY → EVICTED
并且在 OFFLOADING 完成前禁止物理页复用;在 PREFETCHING 完成前禁止模型 forward 读取。这就是“抢占栅栏”。LMCache MP 架构中的两阶段写入、读写锁与 TTL lock 提供了部分基础,但最终释放/分配时序必须由推理引擎保证。LMCache MP 内部架构
6.4 分块恢复,而不是一次为整条长上下文预留
如果多个 100K token 请求同时恢复,而每个请求都先申请完整 GPU block 表,再开始 H2D,就可能出现“每个请求都占了一部分页、没有一个能凑齐并推进”的资源死锁。
更安全的做法是:
- 按 KV chunk 或按层分配少量 GPU 页;
- 一边预取下一批,一边让已就绪部分开始计算;
- 设定每个请求的最大 in-flight H2D bytes;
- 使用全局恢复令牌桶,避免恢复洪峰压垮 PCIe/RDMA;
- 将 Chunked Prefill、Chunked Decode 与缓存恢复统一到同一个 token/page budget 中。
7. 借鉴 llama.cpp:把“能跑”“能复用”“能超卖”分开
llama.cpp 的价值不在于拥有与 LMCache/Mooncake 相同的分布式架构,而在于它把资源受限单机上的策略做得直接、可解释。
7.1 llama.cpp 当前提供了哪些可借鉴机制
根据当前 llama-server 参数文档:
--fit默认开启,会根据设备可用内存调整未显式指定的参数;--n-gpu-layers控制多少模型层驻留 GPU,剩余权重留在 CPU;--no-kv-offload关闭 KV 向设备卸载,使 KV 留在主机侧;--cache-type-k/--cache-type-v可以降低 KV 精度以节省容量;--cache-ram为 Prompt Cache 设置 RAM 上限,当前默认 8192 MiB;--cache-idle-slots可把空闲 slot 保存到 Prompt Cache;--slot-save-path支持把 slot KV 保存到磁盘并恢复。
以上参数见 llama.cpp server 官方 README。当前官方参数表中没有 --kv-cpu-pinned,本文不把它视为稳定、通用的 llama.cpp 能力。
7.2 llama.cpp 与 LMCache/Mooncake 的差别
| 维度 | llama.cpp | vLLM/SGLang + LMCache/Mooncake |
|---|---|---|
| 主要环境 | 单机、本地、资源受限 | 服务端、高并发、跨实例或跨节点 |
| KV 驻留策略 | 初始化/上下文创建时做静态设备选择,另有 slot prompt cache | 页式 GPU 活动集 + 外部 L1/L2 + Connector |
| 优先目标 | 让模型在有限资源上能跑;保持配置可解释 | 提升吞吐、TTFT、复用率、集群利用率与弹性 |
| 持久化粒度 | slot 保存/恢复、RAM prompt cache | token/chunk/object 级分层索引与跨实例共享 |
| 调度抽象 | slot 和连续批处理 | 请求/页/Connector/PD 集群多级调度 |
| 数据面 | 主要是本机 CPU/GPU/磁盘 | CPU、NVMe、RDMA、远端共享池、对象后端 |
7.3 最值得借鉴的不是某个参数,而是三条设计原则
第一,显式区分静态放置和动态换出。--no-kv-offload 是创建上下文时的放置选择,不等于运行时在 GPU、CPU 和远端之间自动分层。服务端系统也应该用不同配置项表示“KV 固定驻留 CPU”“Prefix 缓存卸载”“抢占保全”。
第二,先做容量估算与安全余量。llama.cpp 的 --fit 思路可以迁移为服务端的 admission control:在接纳长上下文前,结合模型布局、KV dtype、最大 token 和并发,预估峰值 GPU/CPU/网络容量,避免等到 OOM 才抢占。
第三,把 slot/session 当作可迁移状态。llama.cpp 的 idle-slot cache 与 slot save/restore 提醒我们:Agent 会话不是普通 Prefix 对象,而是一条不断增长的状态链。LMCache 的 SessionManager、Pin/Unpin、配额和 Mooncake 的远端资源池,应该围绕会话价值而不是单块最近访问时间做策略。
8. 显存只能容纳 5 份 KV 时,怎样服务 8 个长请求?
答案需要分两层。
8.1 可以:让 8 个请求都获得进展
可采用请求级轮转:任一时间片保留 5 个请求的 KV 在 GPU,另外 3 个请求被挂起,其 KV 在释放 GPU 页前保存到 CPU。到下一时间片,调度器恢复部分挂起请求,同时换出其他请求。
这需要:
- 调度器在 GPU block 不足时选择受害者;
- Connector 为受害者分配 CPU block,生成 GPU→CPU 映射;
- D2H 完成并过栅栏后,GPU block 才能重新分配;
- 请求重新获得 token budget 时,为其分配新 GPU block;
- H2D 完成后再进入模型 forward;
- CPU 容量不足或传输失败时,回退到重算。
当前 vLLM Ascend 的 PreemptOffloadConnector 已将这一语义产品化:被 Decode 侧调度器抢占的请求会把已计算 KV 从 HBM 保存到 CPU,并在恢复时载回;它与 Prefix Cache Offloading 是不同路径。vLLM Ascend Preempt Offload 文档
8.2 不可以:在没有内核改造时让 8 份 KV 同时参与每一步 Attention
如果 PagedAttention 只读取 GPU KV pool,那么一个请求被换出后就不能继续 Decode。LMCache 或 Mooncake 可以保存它,却不能让 Attention 自动消费 CPU/SSD 上的页。因此“8 个请求同时处理”更准确的说法是 8 个请求并发存在、按时间片轮转推进,而非 8 个请求在每一个 decoding step 都同时执行。
要让非 GPU KV 直接参与计算,还需要:
- Attention 内核按页或按层从主机侧流式取 KV;
- 对滑动窗口、稀疏 Attention、MLA 只加载当前需要的块;
- 在层
N计算时预取层N+1; - 将 H2D 与 GEMM/Attention 重叠;
- 用 pinned memory、UVA、GPUDirect 或 CXL 降低搬运开销;
- 对冷 KV 做量化/压缩,在 GPU 恢复时解压;
- 让调度器同时预算 HBM、PCIe/RDMA 带宽和 copy-engine 时间。
Decode 原本就容易受内存带宽限制。如果每个 token 都要跨 PCIe 或网络读取历史 KV,瓶颈会从显存容量转移到总线带宽,吞吐量可能更差。SSD 和远端层更适合冷 Prefix、持久化与请求恢复,不宜默认进入每个 token 的热 Attention 路径。
9. 可行的优化路线:从 Connector 到调度器、再到 Attention 内核
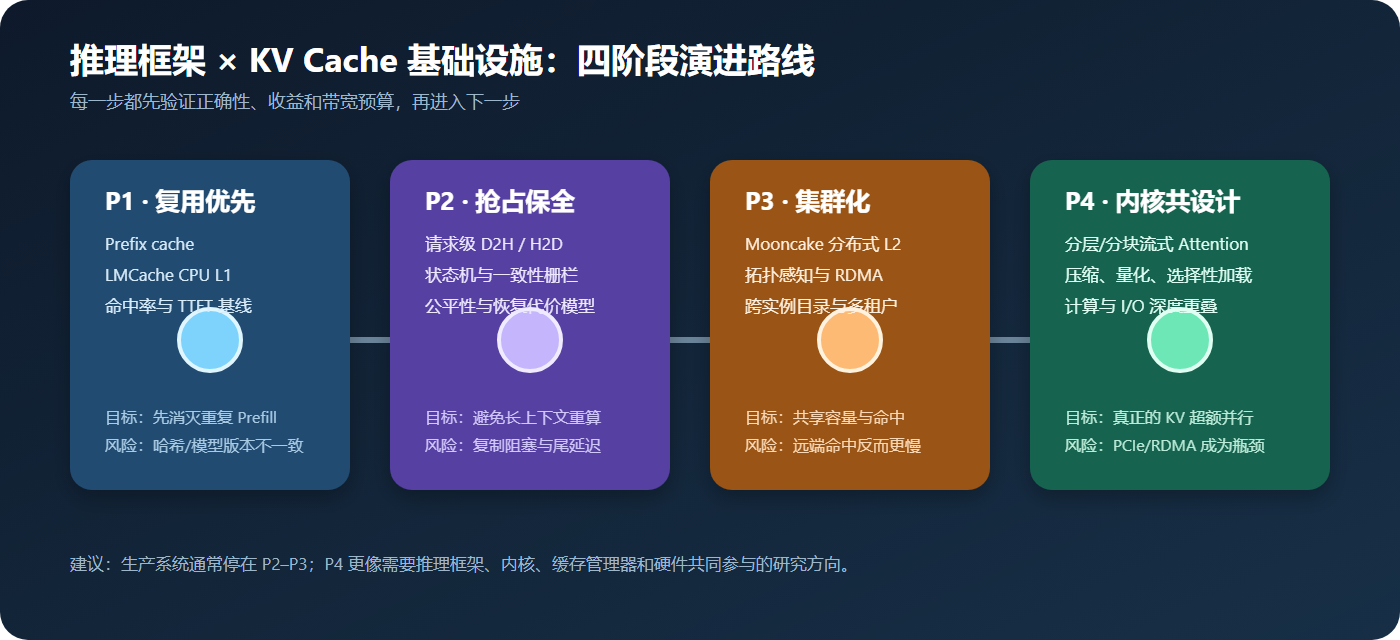
图 7:建议的四阶段落地路线。作者绘制。
9.1 第一阶段:先把 Prefix 复用做扎实
- 用真实 Agent/RAG 流量测 Prefix 重复率,而不是只跑合成全命中测试;
- 记录 GPU/L1/L2 分层命中、TTFT、TPOT、Prefill tokens avoided;
- 建立 cache key 兼容矩阵,模型或 tokenizer 变化时强制失效;
- 将短 Prefix 留给重算,只有收益为正时才访问远端;
- 优先使用 LMCache CPU L1,确认瓶颈确实来自容量后再上 Mooncake L2。
9.2 第二阶段:引入请求级抢占保全
- 在 scheduler 中定义明确的 preempt/resume 状态机;
- 以 I/O 恢复成本、已计算 token、等待年龄和 SLO 联合选择受害者;
- D2H/H2D 使用独立 copy stream、批量页映射和 event;
- 增加 preemption fence,防止物理页被提前覆盖;
- 控制单请求最大恢复窗口,采用 chunked restore 避免死锁;
- CPU offload 池满时必须有确定的重算或拒绝策略。
LMCache 的 Lazy Offload 提供了一个有价值的旁证:它允许 Connector 延迟 Store,并在 GPU block 接近逐出位置时再提交,从而减少不必要的写入;但在块已被复用时会跳过陈旧 Store,让后续命中退化为重算而不是污染缓存。LMCache Lazy Offload
9.3 第三阶段:Mooncake 负责集群级 L2
- 让 LMCache 持有全局 key/token 目录与策略,Mooncake 持有对象与数据路径;
- 根据 NUMA、NIC、GPU 拓扑选择目标 Segment;
- 对高复用 Prefix 做副本,对一次性会话只保留单副本;
- 将写入、读取、复制分别配置线程池,避免 GET-heavy 流量被 Store 挤占;
- 为租户设置 CPU/L2 容量和传输带宽配额;
- 远端读取超时后尽快回退重算,不让 cache miss 变成长尾放大器。
9.4 第四阶段:分层/分块 Attention 共设计
更细粒度的方案,是把 Cache Manager 的 page state 直接暴露给模型执行器,使调度单位从“整个请求”下沉到“层 × 页 × token 区间”。这需要同时修改缓存管理、调度器和 Attention 内核。
可能的执行方式是:
- 当前层只保持热窗口和稀疏选中的历史页在 GPU;
- copy engine 预取下一层的远端页;
- Attention 内核对已到达页分批累积 softmax 统计量;
- 页面计算完成后立即释放或降级回 CPU;
- 对网络抖动设置重算、降采样或等待上限。
这会触及 PagedAttention 内核、block table、CUDA Graph 捕获、TP rank 一致性、混合 Attention 状态、speculative decoding 和调度器 token budget,因此不适合作为第一阶段工程改造。
9.5 Agent 工作负载需要专门策略
Agent 会话具有“长寿命、不断增长、工具结果反复引用”的特征。简单 LRU 往往会淘汰最昂贵的会话状态。更适合的策略包括:
- 会话级 pin、配额和 TTL;
- 对稳定 system prompt、工具 schema、知识文档和增长中的对话尾部分别建模;
- 以“未来 Prefill 可避免的 FLOPs”而不是字节数衡量价值;
- 为多轮会话建立 Prefix DAG,减少相似分支重复存储;
- 对非前缀 RAG 片段使用 CacheBlend 类选择性复用,同时保留必要重算以恢复质量;
- 为每个租户隔离缓存键、密钥与可见性,避免跨租户数据侧信道。
10. 一个更现实的落地建议
单机、本地推理、显存紧张
优先考虑 llama.cpp 的静态权重/KV 放置、KV 量化、RAM Prompt Cache 和 slot save/restore。它不需要引入分布式控制面,故障面和运维成本最低。
单机或单节点 vLLM,重复长上下文明显
先接 LMCache CPU L1,确认重复 Prefix 的命中率与 TTFT 收益。若目标只是跨请求复用,不必过早部署 Mooncake。
多节点 PD 分离,高速 RDMA 网络
优先验证 Mooncake Connector/Transfer Engine 的直接 KV 路径。如果还需要跨实例、跨会话、跨重启的缓存策略,再引入 LMCache 作为管理层与 Mooncake Store 的 L2 前端。
活跃长请求超出 GPU KV 容量
不要只配置 Prefix Offloading 就认为问题解决。确认目标推理框架是否具有“抢占前 D2H 保全、恢复前 H2D 载入”的正式路径。先在 CPU DRAM 层验证;Mooncake/SSD 更适合作为更冷层,不宜直接承担频繁的 token 级换入换出。
建议的验收指标
| 类别 | 指标 |
|---|---|
| 正确性 | 冷/热请求输出一致性、跨版本键隔离、抢占恢复边界、TP rank 一致性 |
| 延迟 | TTFT、TPOT、P50/P95/P99、恢复 stall、远端 miss 回退耗时 |
| 吞吐 | req/s、tok/s、有效 Prefill tokens/s、copy engine 占用 |
| 缓存 | GPU/L1/L2 token 命中率、复用字节数、逐出率、陈旧 Store 跳过率 |
| 调度 | 每请求抢占次数、等待年龄、重入队时间、饥饿请求数、SLO 违约率 |
| 数据面 | D2H/H2D/RDMA/SSD 带宽、队列深度、拥塞、无效预取与重复副本 |
| 成本 | 避免的 Prefill FLOPs、每次命中的 I/O 成本、CPU/SSD/网络增量成本 |
结语
LMCache 提供 KV Cache 的管理层,Mooncake 提供分布式存储和传输数据面。组合部署后,KV 可以离开单个推理进程,在 CPU、本地存储和远端节点之间保存与复用。
LMCache 记录缓存的身份、位置和保留策略,Mooncake 处理跨节点存取。推理框架还要把这些信息纳入请求调度:缓存命中并不自动等于低延迟,恢复时间、链路拥塞和请求 SLO 都要一起计算。
llama.cpp 的做法适合提醒服务端系统区分三件事:静态 CPU KV 解决“能不能运行”,Prefix Cache 解决“能不能少算”,抢占保全解决“挂起后能不能低成本恢复”。前两类能力已经比较成熟;层级或分页流式 Attention 仍需要推理框架与内核配合,不宜和普通缓存卸载混为一谈。
工程上应先测 Prefix 重复率、重算成本和各层传输带宽,再决定缓存层级。对大多数部署,CPU L1、请求级抢占保全和远端冷缓存已经覆盖主要需求;只有在这些手段仍不足时,才值得继续下沉到 Attention 内核。
资料与延伸阅读
官方文档
- LMCache 官方中文文档
- LMCache 多进程模式与内部架构
- LMCache 二级 KV 存储
- LMCache 的 Mooncake Store L2 适配器
- LMCache Lazy KV Cache Offload
- LMCache 基准测试教程
- Mooncake 快速入门
- Mooncake 架构
- Mooncake Store
- Mooncake Transfer Engine
- Mooncake × LMCache 官方集成说明
- Mooncake 的 vLLM PD 分离基准
- vLLM KV Offloading Usage Guide
- vLLM Ascend Preempt Offload Guide
- llama.cpp server 参数文档
- llama.cpp 自动 fit 参数说明